线性回归可以说是最基础的机器学习模型,本文将对此模型做一个分析,并介绍常见的线性回归模型的训练方法。以及由此衍生出的逻辑回归(LR),多分类。
线性回归模型
首先提出一个小问题,如果在一个平面上给出一些点,现在让找到一条直线来拟合这些点,请问该如何寻找这条直线?最小二乘法给了我们答案。如果所有的点到这条直线的距离最小,那么我们就算是找到了这条直线了。注意我这里说的距离不是欧式几何严格意义上的点到直线距离。我们以一元线性回归为例,我们要求解的函数形式为hθ(x)=θ0+θ1x1,其损失函数为 J(θ)=2m1∑i=1m(hθ(xi)−yi)2
\labellossfuncJ(θ)=2m1i=1∑m(hθ(x(i))−y(i))2
正规方程法
在讲梯度下降法之前,我们先把上述的\reflossfunc写成矩阵的形式, 假设所求方程的矩阵形式为f(θ)=Xθ,那么其损失函数如下:
\labellossfuncmatrixJ(θ)=2m1(Xθ−y)T(Xθ−y)
针对θ求导,可以参考矩阵求导法则,主要用到的性质是 ∂X∂XTA=A:
\labelpartialLoss∂θ∂J(θ)=∂θ∂(Xθ−y)T(Xθ−y)+(Xθ−y)T∂θ∂(Xθ−y)=∂θ∂θTXT(Xθ−y)+(Xθ−y)TX=2XT(Xθ−y)
令上述\refpartialLoss为零,得到:
θ=(XTX)−1XTy
一般当XTX为满秩矩阵或者正定矩阵时存在逆矩阵,所以一般情况下我们会引入正则化,以L2正则化为例,
θ=(XTX+λI)−1XTy
梯度下降法
在开始讲梯度下降法之前,我们先复习一下高等数学里面的一些概念
导数反应的变化率:一个函数在某一点的导数描述了这个函数在这一点附近的变化率。导数的本质是通过极限的概念对函数进行局部的线性逼近。
偏导数反应的某个方向的变化率:一个函数在某一点的偏导数描述了这个函数在这一点某个方向附近的变化率。
- 方向导数 方向导数是函数沿各个方向的导数,梯度是一个向量,因此梯度本身是有方向的:
函数在梯度这个方向的方向导数是最大的,换句话说,一个函数在各个方向都有方向导数,其中梯度这个方向的导数为最大
函数方向导数的最大值为梯度的模。
- 梯度 在微积分里面,对多元函数的参数求∂偏导数,把求得的各个参数的偏导数以向量的形式写出来,就是梯度。
比如函数f(x,y), 分别对x,y求偏导数,求得的梯度向量就是(∂f/∂x, ∂f/∂y)T,简称grad f(x,y)或者▽f(x,y)。
对于在点(x0,y0)的具体梯度向量就是(∂f/∂x0, ∂f/∂y0).或者▽f(x0,y0),如果是3个参数的向量梯度,就是(∂f/∂x, ∂f/∂y,∂f/∂z),以此类推。
具体来说,对于函数f(x,y),在点(x0,y0),沿着梯度向量的方向就是(∂f/∂x0, ∂f/∂y0)的方向是f(x,y)增加最快的地方。或者说,沿着梯度向量的方向,更加容易找到函数的最大值。反过来说,沿着梯度向量相反的方向,也就是 -(∂f/∂x0, ∂f/∂y0)的方向,梯度减少最快,也就是更加容易找到函数的最小值。
所以梯度下降法的迭代公式为
x(k+1)=x(k)−αkablaf(x(k))
从一元线性回归到多元线性回归
一元线性回归损失函数如\refexample所示,
\labelexampleJ(θ)J(θ)=2m1i=1∑m(θ0+θ1x(i)−y(i))2=2m1i=1∑m(θ0+θ1x(i)−y(i))2+2λθ02+2λθ12
对应的梯度为
\labelgrad(m1i=1∑m(θ0+θ1x(i)−y(i))(m1i=1∑m(θ0+θ1x(i)−y(i))+λθ0,m1i=1∑m(θ0+θ1x(i)−y(i))x(i)),m1i=1∑m(θ0+θ1x(i)−y(i))x(i)+λθ1)
仔细观察上述梯度公式,可以改写成矩阵表达形式,其中θ=[θ0θ1],
X=1⋮1x(1)⋮x(m)
m1XT(Xθ−y)m1XT(Xθ−y)+λθ
所以最终我们会有θ的更新公式
\labelupdatethetaθ^θ^:=θ−α(m1XT(Xθ−y)):=θ−α(m1XT(Xθ−y)+λθ)
以上\refupdatetheta的矩阵的梯度下降描述不仅适用一元回归,也可以拓展到多元线性回归。
BGD、SGD和MBGD
简单来说BGD(批量梯度下降法)就是每次更新参数时会用到所有的样本,而SGD(随机梯度下降)每次更新参数时只使用一个样本, MBGD(小批量梯度下降法)每次更新参数时使用m个样本。但是参数θ的更新公式和上述的公式\refupdatetheta一致。
python举例
def geberate_date(a, b, x_disturbance, y_disturbance):
    #构造数据,加入噪声
    x = np.random.randint(1, high=100 , size=10, dtype=int).tolist()
    y = list(map(lambda x: a*x + b, x))
    x = list(map(lambda x : [1.0, x + x_disturbance * (0.5 - np.random.rand())], x))
    y = list(map(lambda x: x + y_disturbance * ( 0.5 - np.random.rand()), y))
    return np.array(x), np.array(y)

def gd_linear_regression(x, y, theta, lamda=0.0, alpha=0.1):
    # BGD更新
    print("theta ", theta)
    theta -= alpha * ((x.T.dot((x.dot(theta) - y)))/len(x) + lamda * theta)
    return theta

def mse(theta, x, y):
    # mean square error
    return (((x.dot(theta) - y)**2).sum())/2/len(x)


def iter_gd(x, y, iter=100):
    it = 0
    theta = np.array([2.3, 3.9])
    while(it < iter):
        theta = gd_linear_regression(x, y, theta, lamda=0.0, alpha=0.001)
        print("mse ", mse(theta, x, y))
        it += 1

if __name__ == '__main__':
    x, y = geberate_date(3.9, 7.8, 0.5, 0.5)
    iter_gd(x, y)
调参注意事项:
-
遇到梯度爆炸时,需要减少alpha学习速率,当发现损失函数在每次迭代时不减反增,需要减小alpha的值,直到观察到损失函数在减小
-
在完成第一个迭代后, 应该会发现mse减小的速率越来越小,此时可以将最后的theta参数作为一个初始值,将学习速率alpha调大,重新开始迭代
-
重复以上步骤直到mse符合预期
归一化
特征归一化常用的方法包含如下几种:
- 简单缩放
- 逐样本均值消减(也称为移除直流分量)
- 特征标准化(使数据集中所有特征都具有零均值和单位方差)
数据归一化的好处:
如下图所示,蓝色的圈圈图代表的是两个特征的等高线。其中左图两个特征X1和X2的区间相差非常大,X1区间是[0,2000],X2区间是[1,5],其所形成的等高线非常尖。当使用梯度下降法寻求最优解时,很有可能走“之字型”路线(垂直等高线走),从而导致需要迭代很多次才能收敛;
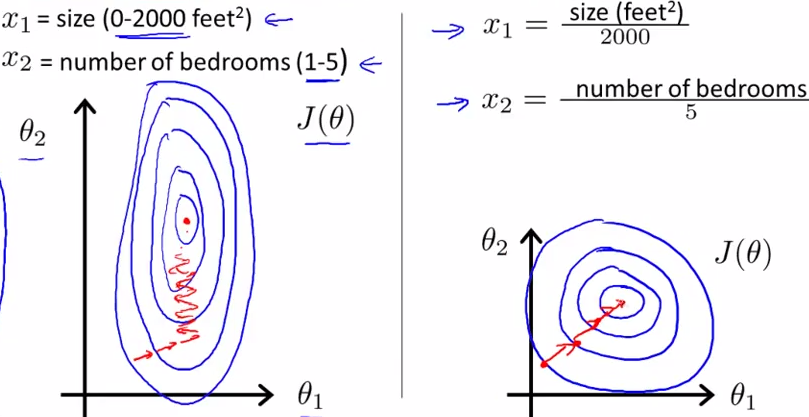 而右图对两个原始特征进行了归一化,其对应的等高线显得很圆,在梯度下降进行求解时能较快的收敛。因此如果机器学习模型使用梯度下降法求最优解时,归一化往往非常有必要,否则很难收敛甚至不能收敛。
一些分类器需要计算样本之间的距离(如欧氏距离),例如KNN。如果一个特征值域范围非常大,那么距离计算就主要取决于这个特征,从而与实际情况相悖(比如这时实际情况是值域范围小的特征更重要)。
下面介绍一些具体的归一化方法
线性回归与逻辑回归
如果一定要用最简单的话来描述逻辑回归(对数几率回归),就是找了一个单调可微的函数将分类任务的真实标记和线性回归的模型联系起来。比如这个公式ln1−yy=Xθ,我们将y看做样本正例的可能性, 1−y看做其反例的可能性,两者的比值称为“几率”,反映了x作为正例的相对可能性。
极大似然估计
极大似然估计(maximum likelihood estimation),通俗理解来说,就是利用已知的样本结果信息,反推最具有可能(最大概率)导致这些样本结果出现的模型参数值!换句话说,极大似然估计提供了一种给定观察数据来评估模型参数的方法,即:“模型已定,参数未知”
极大似然估计中采样需满足一个重要的假设,就是所有的采样都是独立同分布的。
总结起来,最大似然估计的目的就是:利用已知的样本结果,反推最有可能(最大概率)导致这样结果的参数值。
原理:极大似然估计是建立在极大似然原理的基础上的一个统计方法,是概率论在统计学中的应用。极大似然估计提供了一种给定观察数据来评估模型参数的方法,即:“模型已定,参数未知”。通过若干次试验,观察其结果,利用试验结果得到某个参数值能够使样本出现的概率为最大,则称为极大似然估计。
如果是θ^是参数空间中能使似然函数l(θ)最大的θ,则应该是“最可能”的参数值,那么θ^就是θ的极大似然估计量。
似然函数和对数似然函数:
DL(θ)l(θ)=x(1),x(2),⋯,x(N)=P(D∣θ)=p(x(1),x(2),⋯,x(N)∣θ)=i=1∏i=NP(x(i)∣θ)=lnL(θ)=lnP(D∣θ)=i=1∑i=NlnP(x(i)∣θ)
在线性回归中,我们会用Mean Square Error作为损失函数J(θ)=∑i=1n(Xθ−y)2,但是在一个二分类问题中,Mean Square Error将不会是一个凸函数,这是因为y的取值是离散的。非凸函数不利于极值求解。我们需要重新寻找损失函数。
如果我们把每一条样本都看成是一次后验概率的发生,即P(y∣x;θ),并且我们能取得的样本是在(x; \theta)情况下最有可能(概率最大)的结果(极大似然估计思想)。
ϕ(z)zP(y∣x,θ)=1+e−z1=xθ=ϕ(z)y(1−ϕ(z))(1−y)
我们在结合对数似然函数:
l(θ)=i=1∑nlnP(y(i)∣x(i);θ)=i=1∑nlnϕ(z(i))y(i)(1−ϕ(z(i))(1−y(i)))=i=1∑ny(i)lnϕ(z(i))+(1−y(i))ln(1−ϕ(z(i))
我们现在要求的是使得l(θ)最大的θ。没错,我们的代价函数出现了,我们在l(θ)前面加个负号不就变成就最小了吗?不就变成我们代价函数了吗?
\labelmlecostJ(θ)z(i)ϕ(z(i))=−N1l(θ)=−N1i=1∑ny(i)lnϕ(z(i))+(1−y(i))ln(1−ϕ(z(i))=x(i)θ=1+e−z(i)1
为了更好地理解这个代价函数,我们不妨拿一个样本来看看
J(ϕ(z),y;θ)=−ylnϕ(z)−(1−y)ln(1−ϕ(z))
既有:
J(ϕ(z),y;θ)={−lnϕ(z),−ln(1−ϕ(z)),if y = 1if y = 0
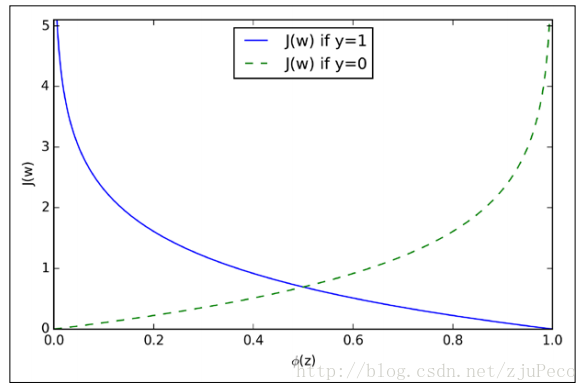
从图中不难看出,如果样本的值是1的话,估计值ϕ(z)越接近1付出的代价就越小,反之越大;同理,如果样本的值是0的话,估计值\phi(z)越接近0付出的代价就越小,反之越大。
散度与交叉熵
熵用来描述一个系统中的不确定性,在不同领域又会有不一样的解释。在信息论中,一个事件发生的概率越大,所携带的信息量越小,熵(Entropy)是信息量的期望,并且编码长度与概率之间的关系是:概率越大,需要的编码二进制位越少。p(x)的最优编码是logp(x)1
\labelentropyL(x)H(p)=logp(x)1=x∑p(x)logp(x)1
如公式\refentropy所示,H表示概率分布p(x)的平均码长,信息量的多少与概率分布相关,概率分布越分散,不确定性越高,信息量越大。
交叉熵的定义:对于一个概率分布p(x),使用另一个概率分布q(x)的最优编码,得到的平均码长Hq(p), 称为p对q的交叉熵。注意交叉熵具有不对称性,Hq(p)eqHq(p)
Hq(p)=x∑p(x)logq(x)1
K-L divergence 表示交叉熵与熵的差值,表达了两个分布之间的差异程度
Dq(p)=Hq(p)−H(p)=x∑p(x)logq(x)1−x∑p(x)logp(x)1=x∑p(x)logq(x)p(x)
显而易见,K-L divergence 也不具有对称性。同时,Dq(p)=Hq(p)−H(p) 也表示在真实分布p的前提下使用q分布编码所多出来的bit数。
机器学习的过程就是希望在训练数据上模型学到的分布和真实数据分布越来越接近,但是我们无法得知真实数据的分布,只能让模型学到的分布和训练数据的分布接近。因为我们会假设训练数据都是iid采样得来的。所以我们可以利用最小化训练数据的经验误差来近似泛化误差的减小。因为Dq(p)=Hq(p)−H(p)其中p是训练数据的分布,是一个已知分布。所以最小化散度就变成交叉熵最小。
所以逻辑思路是,为了让学到的模型越来越接近真实数据分布,我们最小化 模型分布 和 训练数据之间的KL散度,又因为训练数据的分布是固定的,所以会等价为最小化交叉熵。
现在我们从交叉熵出发Hq(p)=−∑xp(x)logq(x),推导出逻辑回归的损失函数
输出的y的概率分布函数应该如图所示,
p(y)={y,1−y,y = 1y = 0
假定的q(y^)分布和p(y)形式一致:
q(y^)={y^1−y^
所以我们会有:
\labelonesamplecross−x∑p(x)logq(x)y^=−y=0,1∑p(y)logq(y^)=−(ylogy^+(1−y)log(1−y^))=1+e−xθ1
注意上述公式\refonesamplecross是单个样本的交叉熵, 实际情况是我们会有符合iid条件的n个样本,需要对交叉熵进行求和取平均值,最终我们得到的损失函数如下:
\labelcrossentropycosty^(i)J(θ)=1+e−x(i)θ1=−N1i=1∑ny(i)logy^(i)+(1−y(i))log(1−y^(i))
通过交叉熵推导的损失函数公式\refcrossentropycost与通过最大似然估计推导的损失函数公式\refmlecost是一致的。
使用梯度下降求解逻辑回归
∂θj∂J=∂ϕ(z)∂J∂z∂ϕ(z)∂θj∂z=−N1i=1∑n(ϕ(z(i))y(i)−1−ϕ(z(i))1−y(i))ϕ(z(i))(1−ϕ(z(i)))xj(i)=−N1i=1∑n(y(1−ϕ(z(i)))−(1−y)ϕ(z(i)))xj(i)=−N1i=1∑n(y(i)−ϕ(z(i)))xj(i)=−N1(y−Φ(z))Txj
所以最终的梯度更新公式为
\labellogitgd∂θ∂Jθ^=−N1(y−1+e−Xθ1)TX:=θ−α(N1(1+e−Xθ1−y)TX+λθ)
多分类学习
现实中常常会遇到多分类学习任务,有些二分类学习方法可以直接拓展到多分类,但是在更多情况下,我们会基于一些基本的策略,利用二分类学习器来解决多分类问题。多分类学习器的基本思路是”拆解法”,即将多分类任务拆解为若干个二分类任务,为每一个二分类任务训练一个分类器,在测试时,对这些分类器的预测结果进行集成以获得最终的多分类结果。这里的关键是如何进行任务拆解,以及如何对多个分类器进行集成。
- 一对一(One vs One 简称OvO)
具体做法是假设训练集上共有N个类别,将这N个类别两两配对,从而产生N(N-1)/2个二分类任务。训练完成后,在测试阶段,新样本同时提交给所有分类器,于是我们会有N(N-1)/2个分类结果,可以把预测最多的类别作为最终分类结果
- 一对其他(One vs Rest 简称OvR)
OvR则是每次将一个类别作为正例、所有的其他类作为反例来训练N个分类器,在测试时如果仅有一个分类器预测为正例,则对应的类别标记作为最终分类,如果多个分类器预测为正,通常会选择置信度最大的。
- 多对多(Many vs Many 简称 MvM)
MvM是每次将若干个类作为正例,若干个其他类作为反例。MvM的正反类构造有特殊的设计,通过编码矩阵(coding matrix)指定。
类别不平衡问题
机器学习中常常会遇到数据的类别不平衡(class imbalance),也叫数据偏斜(class skew)。以常见的二分类问题为例,我们希望预测病人是否得了某种罕见疾病。但在历史数据中,阳性的比例可能很低(如百分之0.1)。在这种情况下,学习出好的分类器是很难的,而且在这种情况下得到结论往往也是很具迷惑性的。
以上面提到的场景来说,如果我们的分类器总是预测一个人未患病,即预测为反例,那么我们依然有高达99.9%的预测准确率。然而这种结果是没有意义的。
如果某类的样本数量很少,那么这个类别所提供的“信息”就太少。使用经验风险(模型在训练集上的平均损失)最小化作为模型的学习准则。设损失函数为0-1 loss(这是一种典型的均等代价的损失函数),那么优化目标就等价于错误率最小化(也就是accuracy最大化)。考虑极端情况:1000个训练样本中,正类样本999个,负类样本1个。训练过程中在某次迭代结束后,模型把所有的样本都分为正类,虽然分错了这个负类,但是所带来的损失实在微不足道,accuracy已经是99.9%,于是满足停机条件或者达到最大迭代次数之后自然没必要再优化下去,ok,到此为止,训练结束!于是这个模型没有学习到如何去判别出少数类。
考虑二项Logistic回归模型。输入一个样本x ,模型输出的是其属于正类的概率y^ 。当y^>0.5; 时,模型判定该样本属于正类,否则就是属于反类。
为什么是0.5呢?可以认为模型是出于最大后验概率决策的角度考虑的,选择了0.5意味着当模型估计的样本属于正类的后验概率要大于样本属于负类的后验概率时就将样本判为正类。但实际上,这个后验概率的估计值是否准确呢?
从几率(odds)的角度考虑:几率表达的是样本属于正类的可能性与属于负类的可能性的比值。模型对于样本的预测几率为1−y^y^
模型在做出决策时,当然希望能够遵循真实样本总体的正负类样本分布:设y等于正类样本数除以全部样本数,那么样本的真实几率为1−yy 。当观测几率大于真实几率y^>y;,那么就判定这个样本属于正类。虽然我们无法获悉真实样本总体,但之于训练集,存在这样一个假设:训练集是真实样本总体的无偏采样。正是因为这个假设,所以认为训练集的观测几率就代表了真实几率。所以在这个假设下,当一个样本的预测几率大于观测几率时,就应该将样本判断为正类。
类别不平衡的评估
- ROC是一种常见的替代方法,全名receiver operating curve,计算ROC曲线下的面积AUC是一种主流方法
- 使用F1指标评价
- 使用precision-recall图
处理类别不平衡的常用方法
- 再缩放
假设y^是预测的正例值,m+表示正例数目,m−表示负例数目,那么我们对于预测几率进行再缩放
1−yˇyˇ=1−y^y^×m+m−,那么此时再和默认阈值0.5去比较。
对于二分类问题,可以通过再缩放获得理论最优解,但对于多分类问题大多数情况不存在闭式解。
- 欠采样
去除一些较多的类别,使得正反例数目接近。但是要注意随机丢弃反例可能会丢失重要信息。欠采样的代表性算法是利用集成学习机制(比如随机森林),将反例划分为若干个集合共不同学习器使用,这样对每个学习器来说都进行了欠采样,但是从全局看不会丢失重要信息。
- 过采样
过采样会增加一些正例,但是过采样法不能简单的增加正例,这样会导致严重的过拟合。代表性算法有SMOTE,其核心思想是通过对正例进行插值来产生额外正例。
softmax
之前讨论过多分类问题可以拆解成一系列二分类问题,那有没有直接可以用于多分类的模型呢? 答案就是softmax,它可以直接对多类别进行分类。
softmax函数的本质是将一个K维的任意实数向量压缩(映射)成另一个K维的实数向量,其中向量中的每个元素取值都介于(0,1)之间,而且所有元素之和为1。
S(zj)=∑i=1neziezj
我们需要损失函数返回预测结果与真实结果之间的差距,并进行梯度下降进行参数更新。实际上,softmax回归更多地是用在神经网络输出层的后面,得到损失函数后进行反向传播更新,当然也可以直接套用一个线性模型。
下面我们用梯度下降法推导出softmax的参数更新公式,其损失函数形式依然是从交叉熵出发, 先来看单个样本的损失函数J′,并且假设类别个数为k
J′y^i∂y^∂J′∂zj∂y^i=∂zj∂∑k=1kezkezi∂zj∂J′=−∑p(x)logq(x)=−i=1∑kyilog(y^i)=∑i=1keziezi=−i=1∑kyiy^i1={∑2ezi∑−eziezj=∑ezi(1−∑ezi)=y^i(1−y^i)−ezi∑2ezj=−y^iy^ji=jieqj=−(∑kyiy^i1)∂zj∂y^i=−y^iyiy^i(1−y^i)+ieqj∑ky^jyiy^iy^j=−yi+yiy^i+ieqj∑kyiy^i=−yi+j=1∑kyjy^i=−yi+y^ij=1∑kyj=y^i−yi
我们把单个样本损失函数用矩阵形式表示
θz∂θ∂J′=θ1Tθ2T⋮θkT=[θ1Txθ2Tx⋯θkTx]T=θx=∂z∂J′∂θ∂z=(y^−y)Tx
最后我们需要考虑所有样本的损失函数均值最小,即把上面的式子进行求和取平均,假设我们的样本总数为N
∂θ∂Jθ^=N1[y^(1)−y(1)y^(2)−y(2)⋯y^(n)−y(n)]x(1)x(2)⋯x(n)=N1(Y^−Y)TX:=θ−α(N1(Y^−Y)TX+λθ)
事实上对于一个线性模型,它的梯度下降法参数更新公式都可以统一到下面这个公式
\labellinearunityθ^:=θ−α(N1(Y^−Y)TX+λθ)
python softmax实现
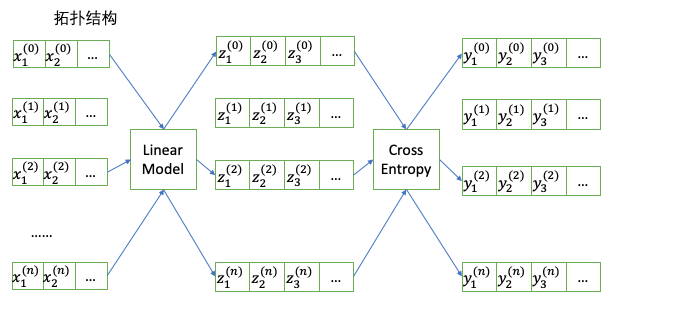
拓扑结构如下图所示:
import tensorflow as tf
import numpy as np


def softmax(input):
    exp_value = np.exp(input)  # 首先计算指数
    output = exp_value / np.sum(exp_value, axis=1)[:, np.newaxis]  # 然后按行标准化
    return output

class CrossEntropyLossLayer():
    def __init__(self):
        pass

    def forward(self, input, labels):
        # 做一些防止误用的措施,输入数据必须是二维的,且标签和数据必须维度一致
        assert len(input.shape) == 2, '输入的数据必须是一个二维矩阵'
        assert len(labels.shape) == 2, '输入的标签必须是独热编码'
        assert labels.shape == input.shape, '数据和标签数量必须一致'
        self.data = input
        self.labels = labels
        self.prob = np.clip(softmax(input), 1e-9, 1.0)  # 在取对数时不能为 0,所以用极小数代替 0
        loss = -np.sum(np.multiply(self.labels, np.log(self.prob))) / self.labels.shape[0] #根据交叉熵定义
        return loss

    def backward(self):
        self.grad = (self.prob - self.labels) / self.labels.shape[0]  # 根据公式计算梯度


def get_data():
    mnist = tf.keras.datasets.mnist
    i = np.eye(10, dtype=np.uint8)
    (x_train, y_train), (x_test, y_test) = mnist.load_data()
    print(x_train.shape, y_train.shape, x_test.shape, y_test.shape)
    x_train = np.c_[np.ones(x_train.shape[0]),np.reshape(x_train, (60000, -1)) / 255]
    x_test = np.c_[np.ones(x_test.shape[0]), np.reshape(x_test, (10000, -1)) / 255]
    y_train = np.array(list(map(lambda x: i[x], y_train.tolist())))
    y_test = np.array(list(map(lambda x: i[x], y_test.tolist())))
    print(x_train.shape, y_train.shape, x_test.shape, y_test.shape)

    return x_train, y_train, x_test, y_test


if __name__ == '__main__':
    x_train, y_train, x_test, y_test = get_data()
    alpha = 0.01
    lambd = 0.000
    theta = np.random.randn(x_train.shape[1], y_train.shape[1]) * 0.01  # 高斯初始化,均值为 0,标准差 0.01

    cross_entropy_layer = CrossEntropyLossLayer()
    for epoch in range(1000): #每次迭代计算准确率

        # train
        loss = cross_entropy_layer.forward(np.matmul(x_train, theta), y_train)
        cross_entropy_layer.backward()
        theta -= alpha * ( np.matmul(x_train.T, cross_entropy_layer.grad) + lambd * theta)

        # test
        test_pred = np.matmul(x_test, theta)
        pred_labels = np.argmax(test_pred, axis=1)
        real_labels = np.argmax(y_test, axis=1)
        acc = np.mean(pred_labels == real_labels) # python false is 0 while true is 1

        print("epoch ", epoch, "loss ", loss, "acc ", acc)
小结
-
对于线性模型的L2损失函数,如果采用梯度下降法,可以归纳到这个式子θ^:=θ−α(N1(Y^−Y)TX+λθ)
-
我们用交叉熵来解释分类问题的损失函数,让学到的模型越来越接近真实数据分布,我们最小化模型分布和训练数据 之间的KL散度,又因为训练数据的分布是固定的,所以会等价为最小化交叉熵。
-
在调参过程中,出现梯度爆炸需要先减小学习速率α,对于训练数据的归一化可以加快梯度下降最优解的速度
-
处理类别不平衡问题的常用方法有再缩放,欠采样,过采样。
参考:
-
<https://zhuanlan.zhihu.com/p/36691384>
-
<https://zhuanlan.zhihu.com/p/27223959>